تحديات رقمنة الذاكرة العربية وكيف يواجه الذكاء الاصطناعي صعوبة قراءة النصوص
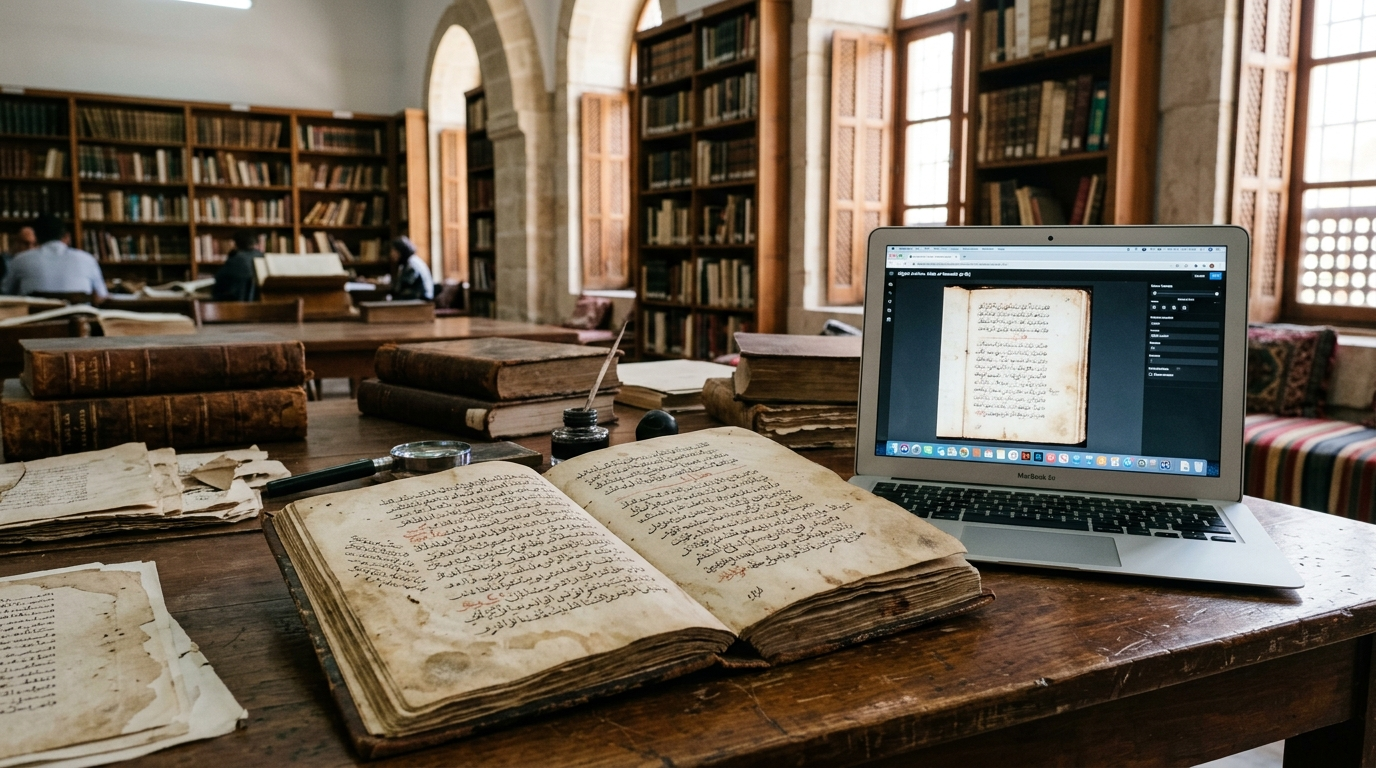
تواجه الذاكرة العربية المتمثلة في آلاف الوثائق والمخطوطات والصحف التاريخية تحديات تقنية كبيرة في مسيرة تحولها الرقمي. حيث لا تزال هذه الذاكرة حبيسة الصور الرقمية التي لا تستطيع محركات البحث أو نماذج الذكاء الاصطناعي فهم محتواها بشكل كامل. مبينا أن الانتقال من مجرد تصوير الوثائق إلى تحويلها لنصوص قابلة للقراءة آليا يمثل الفجوة الحقيقية في عصر الرقمنة.
أظهرت الحاجة الملحة لتطوير تقنيات التعرف الضوئي على الحروف (OCR) والتعرف على الكتابة اليدوية (HTR) ضرورة وجود كميات ضخمة من البيانات المدربة. وكشفت مبادرة سرد التي أطلقها باحثون في جامعة الأمير سلطان وأكاديمية طويق السعودية عن حجم هذه الفجوة. إذ وفرت المجموعة أكثر من 2.6 مليون صورة لصفحات عربية تحاكي تخطيطات الكتب. موضحا أن هذه البيانات تهدف إلى تدريب النماذج على قراءة الصفحات كاملة وليس مجرد كلمات منفردة.
قال وديع بوليلة مدير مختبر الروبوتات وإنترنت الأشياء إن الهدف من هذه الجهود هو سد النقص في البيانات اللازمة للتعرف على النصوص العربية. وأضاف أن التحدي لا يتوقف عند النص المطبوع. بل يمتد إلى المخطوطات والوثائق القديمة التي تحمل تعقيدات بصرية وتاريخية تحتاج إلى خبرات بشرية متخصصة للتحقق منها وضمان دقتها.
أوضح حمدي مبارك المهندس الرئيسي في معهد قطر لبحوث الحوسبة أن قراءة الوثائق القديمة تواجه عقبات تقنية تتمثل في تلف الورق وبقع الحبر وتشابك الحروف وغياب التشكيل. مبينا أن الأخطاء في استخراج النصوص قد تتفاقم وتنتقل إلى نماذج الذكاء الاصطناعي التوليدي. مما يؤدي إلى تشويه الحقائق التاريخية أو ضياع المعلومات عند البحث عنها.
كشفت التجارب أن العملية لا تنتهي بمجرد تحويل الوثيقة إلى ملف رقمي. بل تتطلب نظاما دقيقا للتدقيق والمراجعة. وأكد الخبراء أن الرقمنة الناجحة للذاكرة العربية يجب أن تحافظ على الرابط الوثيق بين النص المستخرج والصورة الأصلية. مع ضرورة توثيق المصادر والسياق التاريخي لضمان بقاء التراث العربي متاحا للبحث العلمي والمعرفة بأمانة وموثوقية.